Datenverarbeitung jenseits des RAMs. Fokus: Zero-Copy, spaltenorientierte Formate und Lazy-Evaluation.
Worum es geht. Datenmengen, die nicht mehr in den Arbeitsspeicher passen. Drei Ideen tragen das Kapitel: spaltenweise statt zeilenweise speichern (Parquet), Daten zwischen Werkzeugen ohne Serialisierung bewegen (Arrow), und Berechnungen erst vollständig planen und dann ausführen (Lazy Evaluation).
Was Sie danach können. Begründen, wann Parquet einer CSV überlegen ist und wann nicht; einen Polars-Lazy-Query lesen und erklären, warum scan_parquet günstiger ist als read_parquet; und anhand der Datenmenge entscheiden, ob Pandas, Polars oder ein verteiltes System das Richtige ist.
Die Java-Entsprechung in einem Satz. Lazy Evaluation in Polars ist dieselbe Idee wie Javas Stream-API — die Kette der Operationen wird erst beim abschließenden Aufruf ausgeführt, und genau das erlaubt es, sie vorher umzustellen.
!uv venv --quiet
!uv sync --quiet
!uv pip --quiet install polars pyarrow pandas scikit-learn
Numpy 2.0 ABI: Achte auf Versionen: Pandas 2.2.0, Matplotlib 3.9.0, Scikit-Learn 1.5.0.
Array-Alternativen:
cupyfür GPU-Beschleunigung oderjax.numpyfür Auto-Differentiation.
Architektur-Prinzipien
Row- vs. Columnar: CSV/JSON (Row) speichert Datensätze zusammen – schlecht für analytische Abfragen. Parquet (Columnar) speichert Spalten zusammen – ideal für Aggregation und Kompression.
Zero-Copy (Apache Arrow): Standardisiertes Speicherformat. Verschiebt Daten zwischen Tools (Polars, PyTorch, Arrow) ohne Serialisierungs-Overhead.
Out-of-Core: Verarbeitung von Datensätzen, die den RAM übersteigen, durch Chunking (I/O-Iteratoren) oder Lazy-Evaluation.
Polars & Lazy Evaluation
Polars optimiert den gesamten Query-Plan (Predicate Pushdown, Projection Pushdown) vor der Ausführung. scan_parquet lädt nur Metadaten.
%%writefile polars_writer.py
import polars as pl
import numpy as np
import os

# Ensure data directory exists
os.makedirs("data", exist_ok=True)

# Generate a sample DataFrame
data = {
    "id": np.arange(1000),
    "value": np.random.randint(0, 200, 1000),
    "feature1": np.random.randn(1000),
    "feature2": np.random.randn(1000),
    "target": np.random.randint(0, 2, 1000)
}

df = pl.DataFrame(data)

# Save as Parquet for your scan_parquet tests
df.write_parquet("data/sample1.parquet")
df.write_parquet("data/sample2.parquet")

print("Dummy data created in ./data/ directory.")
Overwriting polars_writer.py
%%writefile polars_reader.py
import polars as pl
# Lazy: Kein I/O, nur Planerstellung
lazy_df = pl.scan_parquet("data/sample*.parquet") \
    .filter(pl.col("value") > 100) \
    .select(["id", "value"])

# Streaming: Verarbeitet in Chunks, RAM-sicher
df = lazy_df.collect(engine="streaming")
Writing polars_reader.py
!uv run polars_writer.py
!uv run polars_reader.py
Dummy data created in ./data/ directory.
import polars as pl
import matplotlib.pyplot as plt

hist_data = (
    pl.scan_parquet("data/sample*.parquet")
    .select(pl.col("target"))
    .collect(engine="streaming")
)

plt.figure(figsize=(10, 5))
plt.hist(hist_data["target"], bins=20, edgecolor="black")
plt.title("Distribution of 'target' from Parquet Files")
plt.xlabel("target")
plt.ylabel("Frequency")
plt.grid(axis="y", alpha=0.5)
plt.show()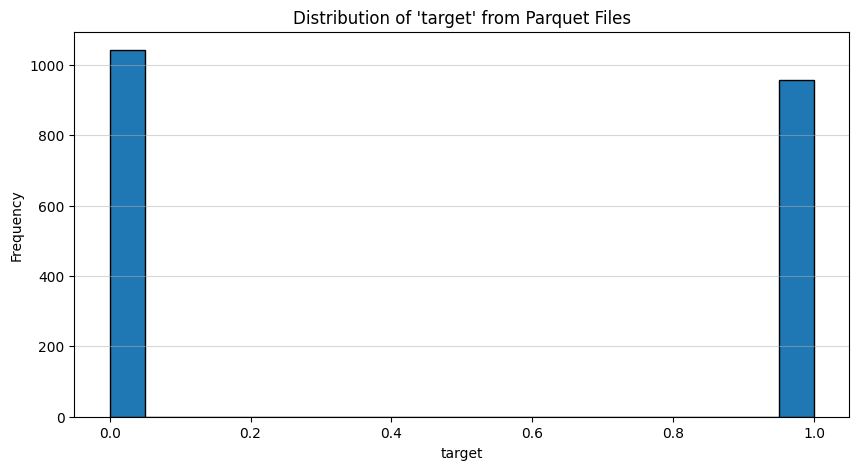
%%writefile sklearn_parquet.py
import polars as pl
from sklearn.linear_model import SGDClassifier

clf = SGDClassifier()
scanner = pl.scan_parquet("data/sample*.parquet")
for chunk in scanner.collect(engine="streaming").iter_slices():
    X = chunk.select(["feature1", "feature2"]).to_numpy()
    y = chunk.select(["target"]).to_numpy().ravel()
    clf.partial_fit(X, y, classes=[0, 1])
Writing sklearn_parquet.py
!uv run sklearn_parquet.pyPyTorch
Nutze torch.as_tensor() für Zero-Copy-Konvertierung von Arrow-Backends.
%%writefile torch_parquet.py
import torch
import polars as pl


class ParquetDataset(torch.utils.data.IterableDataset):
    def __init__(self, path, chunk_size=1000):
        self.path = path
        self.chunk_size = chunk_size

    def __iter__(self):
        df = pl.scan_parquet(self.path).collect(engine="streaming")
        for i in range(0, len(df), self.chunk_size):
            chunk = df.slice(i, self.chunk_size)
            features = chunk.select(["feature1", "feature2"])
            yield torch.as_tensor(features.to_numpy(), dtype=torch.float32)


dataset = ParquetDataset("data/sample*.parquet", chunk_size=1000)
loader = torch.utils.data.DataLoader(dataset, batch_size=None) # batch_size=None because iteration yields batches
model = torch.nn.Linear(2, 1)

# training loop
for batch in loader:
    output = model(batch.float())
    # ... proceed with loss calculation and optimization
Writing torch_parquet.py
Wir starten das Skript mit --with torch, damit torch nicht als projektweite Abhängigkeit deklariert werden muss (denn PyTorch is groß).
!uv run --with "torch" torch_parquet.pyInstalled 29 packages in 231ms
PyArrow
Man kann auch direkt mit PyArrow arbeiten (wobei wir hier sinnloserweise wieder in eine Parquet-Datei schreiben, wozu man den Umweg über Arrow nicht braucht).
%%writefile pyarrow_parquet.py
import polars as pl
import pyarrow as pa
import pyarrow.parquet as pq

lazy_df = pl.scan_parquet("data/sample*.parquet") \
    .filter(pl.col("value") > 100) \
    .select(["id", "value"])
df = lazy_df.collect(engine="streaming")
arrow_table = df.to_arrow()
pq.write_table(arrow_table, "data/compressed.parquet", compression="snappy")
Writing pyarrow_parquet.py
!uv run pyarrow_parquet.py
!stat -c %s data/sample*.parquet
!stat -c %s data/compressed.parquet
21495
21495
4149
Entscheidungsmatrix
Bevor die Matrix Namen nennt, die im Kapitel nicht vorkamen — je ein Satz zu den verteilten Systemen:
Dask spiegelt bekannte APIs (Pandas, NumPy) auf einen Cluster: derselbe Code, verteilt ausgeführt. Der Reiz ist die geringe Umstellung, der Preis ist, dass die Abstraktion an den Rändern durchscheint.
Ray ist allgemeiner und nicht auf Tabellen beschränkt: Es verteilt Funktionsaufrufe und Objekte über einen Cluster und ist deshalb im Machine-Learning-Umfeld verbreitet. Ein Beispiel steht schon im Kapitel Asyncio.
Daft ist der jüngste der drei: eine verteilte DataFrame-Engine in Rust, gebaut auf Arrow, mit Lazy Evaluation wie Polars — sozusagen Polars für mehrere Rechner.
Für die Projekte in diesem Kurs ist keines davon nötig; sie stehen hier, damit die Namen einzuordnen sind, wenn sie auftauchen. Wer SQL direkt auf Parquet-Dateien absetzen will, ohne einen Cluster oder einen DataFrame anzufassen, findet in duckdb die kürzeste Lösung — eine eingebettete analytische Datenbank, die sich zu Parquet verhält wie sqlite3 zu einer Datei.
| Szenario | Empfehlung | Grund |
|---|---|---|
| < 2 GB | Pandas | Viel Code öffentlich |
| > 2 GB, analytisch | Polars | Hohe Performance, Streaming-Support, Gut durchdachte API |
| > RAM, verteilt | Dask / Ray | Horizontale Skalierung auf Cluster-Ebene |
Zusammenfassung und Kontrollfragen
Zeilen- gegen spaltenorientiert ist die erste Entscheidung: CSV und JSON legen ganze Datensätze zusammen, Parquet legt Spalten zusammen — für analytische Abfragen ist das der entscheidende Unterschied.
Apache Arrow ist das gemeinsame Speicherformat, über das Polars, PyTorch und PyArrow Daten ohne Kopie und ohne Serialisierung austauschen.
Lazy Evaluation bedeutet, dass Polars den vollständigen Abfrageplan kennt, bevor gerechnet wird — daher Predicate- und Projection-Pushdown, und daher liest
scan_parquetzunächst nur Metadaten.Out-of-Core heißt, in Blöcken oder faul zu verarbeiten, statt alles in den Speicher zu laden; damit wird die Datenmenge von der Speichergröße entkoppelt.
Die Werkzeugwahl folgt der Datenmenge: unter etwa 2 GB Pandas wegen der Verbreitung, darüber analytisch Polars, jenseits des Arbeitsspeichers und verteilt Dask oder Ray.
Kontrollfragen
Warum liest
scan_parquetzunächst nur Metadaten, und welchen konkreten Vorteil hat das gegenüberread_parquet?Sie haben eine CSV mit 40 Spalten und wollen den Mittelwert einer einzigen davon. Welche Eigenschaft des CSV-Formats macht das teurer als nötig, und was ändert Parquet daran?
Was heißt “Zero-Copy” hier konkret — welche Kosten entfallen, wenn Polars ein Ergebnis an PyTorch übergibt?
!rm -rf data
!rm -f polars_reader.py polars_writer.py pyarrow_parquet.py sklearn_parquet.py torch_parquet.py